5 Casos de uso
En este capítulo se presentan dos casos de uso que demuestran la versatilidad y eficacia de metasurvey en el análisis de encuestas de hogares llevadas a cabo bajo diseños complejos en América Latina. Se abordarán dos encuestas de la región: la Encuesta Continua de Hogares (ECH) de Uruguay y la Encuesta Permanente de Hogares (EPH) de Argentina. Estas encuestas son fuentes esenciales de información sobre el mercado laboral en sus respectivos países y han sido utilizadas en diversos estudios y análisis socioeconómicos.
5.1 Encuesta Continua de Hogares con Paneles Rotativos
5.1.1 Contexto y Cambios Metodológicos
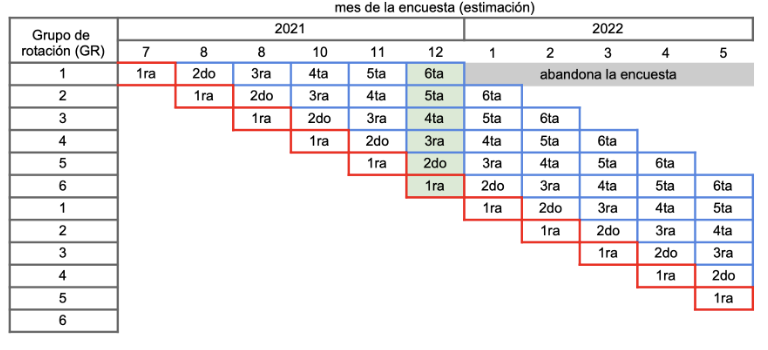
En 2021, la ECH adoptó un diseño de panel rotativo, reemplazando su diseño cross-section anterior. Este cambio permite el seguimiento de hogares durante seis meses, tras lo cual se incorporan nuevos grupos de rotación en el panel, como se muestra en la Figura 5.1 (Instituto Nacional de Estadı́stica, 2021). Esto mejora:
- La precisión de las estimaciones, en especial para brindar mayores aperturas para variables de mercado laboral.
- El análisis de dinámicas laborales.
- La medición de indicadores socioeconómicos.
5.1.2 Carga y Procesamiento de Datos
La ECH es la principal fuente de información sobre el mercado laboral uruguayo desde 1968 y amplió su cobertura nacional en 2006. Los microdatos se encuentran disponibles desde 2006 en el portal ANDA del INE.
Para trabajar con la ECH 2023, se requieren:
- ECH_implantacion_2023.csv: Microdatos de implantación del panel rotativo. Aquí se tiene información de los hogares seleccionados para el panel y sus características junto a información relevada en la encuesta presencial.
- ECH Seguimiento[1-12].csv: Microdatos de seguimiento mensual del panel rotativo. Contienen el relevamiento de información relevada por vía telefónica, incluyendo características relacionadas al mercado laboral.
- Archivos de pesos replicados Bootstrap mensuales (enero-diciembre 2023): Archivos Excel con los pesos replicados para cada mes del año 2023, necesarios para el cálculo de los errores estándar en las estimaciones.
Un aspecto técnico importante es el manejo eficiente de los pesos muestrales replicados. metasurvey optimiza este proceso convirtiendo automáticamente los archivos Excel de pesos bootstrap a formato CSV, mejorando significativamente el rendimiento en análisis posteriores, un ejemplo de la carga de microdatos junto a las réplicas puede verse en Código 5.1.
Código
library(metasurvey)
library(magrittr)

# Actualizar la ruta de los archivos de datos
path_dir <- file.path("/home/runner/work/document_tfg/document_tfg/chapters/example-data", "ech", "ech_2023")

ech_2023 <- load_panel_survey(
    path_implantation = file.path(
        path_dir,
        "ECH_implantacion_2023.csv"
    ),
    path_follow_up = file.path(
        path_dir,
        "seguimiento"
    ),
    svy_type = "ECH_2023",
    svy_weight_implantation = add_weight(
        annual = "W_ANO"
    ),
    svy_weight_follow_up = add_weight(
        monthly = add_replicate(
            "W",
            replicate_path = file.path(
                path_dir,
                c(
                    "Pesos replicados Bootstrap mensuales enero_junio 2023",
                    "Pesos replicados Bootstrap mensuales julio_diciembre 2023"
                ),
                c(
                    "Pesos replicados mensuales enero_junio 2023",
                    "Pesos replicados mensuales Julio_diciembre 2023"
                )
            ),
            replicate_id = c("ID" = "ID"),
            replicate_pattern = "wr[0-9]+",
            replicate_type = "bootstrap"
        )
    )
)
5.1.3 Construcción de Variables e Indicadores
El paquete permite dos enfoques para la construcción de variables:
- Utilizar recetas predefinidas disponibles a través de la API de
metasurvey - Crear recetas personalizadas según necesidades específicas
Por ejemplo, para calcular indicadores del mercado laboral:
Código
ingreso_compatibilizado <- get_recipe(
    svy_type = "ech",
    svy_edition = "2022",
    topic = "ingreso"
)
ingreso_compatibilizado$depends_on
A continuación se presentan algunas recetas que se pueden utilizar para calcular las tasas de mercado de trabajo a nivel mensual, trimestral y anual.
Código
ech_2023 <- ech_2023 %>%
    step_recode(
        "pea",
        POBPCOAC %in% 2:5 ~ 1,
        .default = 0,
        comment = "Población Económicamente Activa",
        .level = "follow_up"
    ) %>%
    step_recode(
        "pet",
        e27 >= 14 ~ 1,
        .default = 0,
        comment = "Población Empleada",
        .level = "follow_up"
    ) %>%
    step_recode(
        "po",
        POBPCOAC == 2 ~ 1,
        .default = 0,
        comment = "Población Ocupada",
        .level = "follow_up"
    ) %>%
    step_recode(
        "pd",
        POBPCOAC %in% 3:5 ~ 1,
        .default = 0,
        comment = "Población Desocupada",
        .level = "follow_up"
    )

ech_2023_bake <- bake_steps(ech_2023)
En el código 5.3 se crean las variables necesarias para el cálculo de las tasas de mercado de trabajo a partir de los microdatos de seguimiento de la ECH 2023. Las variables creadas son: Población Económicamente Activa (PEA), Población Empleada (PET), Población Ocupada (PO) y Población Desocupada (PD). Una cosa importante es que la variable POBPCOAC es una variable construida por el INE que indica la condición de actividad, esta variable se construye a partir de los formularios dentro de metasurvey se encuentra a modo de receta la sintaxis publicada hasta la versión 2019 de la ECH, la misma fue basado en archivos PDF donde se incluían códigos escritos en SPSS para la construcción de la variable. Para años posteriores no fue publicado este documento, se espera en breve dejar disponible la receta para los años 2020 considerando el nuevo formulario y revisando las versiones anteriores.
5.1.4 Estimación de Tasas de Mercado de Trabajo
Una vez creadas las variables básicas, podemos calcular las tasas de actividad, empleo y desempleo utilizando la función workflow. Esta función permite realizar estimaciones a diferentes niveles temporales (mensual, trimestral, anual) y con distintos tipos de agregación.
Estimación por trimestre
Código
mercado_trabajo_mensual <-
    workflow(
        survey = extract_surveys(
            ech_2023_bake,
            quarterly = 1:4
        ),
        survey::svyratio(
            ~pea,
            denominator = ~pet
        ),
        survey::svyratio(
            ~po,
            denominator = ~pet
        ),
        survey::svyratio(
            ~pd,
            denominator = ~pea
        ),
        estimation_type = "quarterly:monthly",
        rho = 0.5,
        R = 5 / 6
)Como se puede ver en el código 5.4 se pueden realizar estimaciones a diferentes niveles temporales y con distintos tipos de agregación, en este caso se realizan estimaciones a nivel trimestral a partir de las estimaciones mensuales, el resultado de la estimación se puede ver en la Tabla 5.1.
Estimación anual
También es posible realizar estimaciones a nivel anual, para esto se debe de considerar las medias de las estimaciones mensuales para cada trimestre y luego realizar la estimación anual.
La nueva metodología puede dar confusiones sobre que microdatos utilizar ya que para estimaciones anuales se consideran los microdatos de implantación y las referidas a mercado de trabajo se consideran los microdatos de seguimiento esto se debe a que el hogar luego de ser seleccionado en la implantación el formulario se realiza por vía telefónica y se centra unicamente a variables referidas al situación de empleo del hogar. Para realizar estimaciones por ejemplo de cantidad de personas que finalizaron un ciclo educativo se debe de considerar los microdatos de implantación a nivel anual.
Código
mercado_trabajo_anual <- workflow(
    survey = extract_surveys(
        ech_2023_bake,
        annual = 2023
    ),
    survey::svyratio(
        ~pea,
        denominator = ~pet
    ),
    survey::svyratio(
        ~po,
        denominator = ~pet
    ),
    survey::svyratio(
        ~pd,
        denominator = ~pea
    ),
    estimation_type = "annual:monthly"
)Podemos ver que se obtiene un objeto donde se tiene las estimaciones de las tasas de mercado de trabajo a nivel mensual, trimestral y anual. En este caso se utilizan las replicas bootstrap para calcular los errores estándar de las estimaciones y se incluye una recomendación sobre la confiabilidad de las estimaciones en base al coeficiente de variación de las estimaciones.
5.2 Encuesta Permanente de Hogares de Argentina
Para demostrar la versatilidad de metasurvey, se presenta un segundo caso de uso con la Encuesta Permanente de Hogares (EPH) de Argentina. La EPH es una encuesta continua de hogares que se realiza en el país desde 1985 y es la principal fuente de información sobre el mercado laboral argentino. Los microdatos de la EPH están disponibles en el portal del INDEC.
Podemos hacer algo similar a lo que hicimos con la ECH, en este caso cargamos los microdatos de la EPH 2022 trimestre 3 y creamos las variables necesarias para el cálculo de las tasas de mercado de trabajo. Estos steps fueron basados en base al formulario de la encuesta y la documentación disponible.
Código
eph2022_3 <- metasurvey::load_survey(
    path = metasurvey::load_survey_example(
        "eph",
        "eph2022_3"
    ),
    svy_type = "eph",
    svy_edition = "eph_202302",
    svy_weight = add_weight(
        monthly = "PONDERA"
    )
) |>
    metasurvey::step_recode(
        "pea",
        ESTADO %in% 1:2 ~ 1,
        .default = 0
    ) |>
    metasurvey::step_recode(
        "pet",
        ESTADO != 4 ~ 1,
        .default = 0
    ) |>
    metasurvey::step_recode(
        "po",
        ESTADO == 1 ~ 1,
        .default = 0
    ) |>
    metasurvey::step_recode(
        "pd",
        ESTADO == 2 ~ 1,
        .default = 0
    )
5.2.1 Visualización de las recetas
Algo interesante que se puede hacer con metasurvey es visualizar las recetas que se utilizan para la construcción de las variables, esto puede ser útil para entender como se construyen las variables y que variables dependen de otras. En este caso se muestra la visualización para la creación de la variable POBPCOAC en la ECH 2019, si bien el INE ya incorpora esta variable en los microdatos, se puede ver como se construye la variable en base a otras variables del formulario.
Código
u_path <- "https://metasurvey-example-data.s3.us-east-2.amazonaws.com/ech/ech_2019.csv"
ech_2019 <- load_survey(
    path = u_path,
    svy_type = "ech",
    svy_edition = "2019",
    svy_weight = add_weight(
        annual = "pesoano"
    ),
    recipes = get_recipe(
        svy_type = "ECH",
        svy_edition = 2019,
        topic = "Mercado de trabajo"
    )
)
ech_2019 <- bake_recipes(ech_2019)
Si bien se puede ingresar a los atributos de la receta para ver las variables que dependen de la misma, se puede visualizar de una forma más amigable con la función view_graph como se puede ver en la Figura 5.2.
POBPCOAC en la ECH 2019 y variables de mercado de trabajo que dependen de la misma.
5.2.2 Compartiendo Recetas entre Usuarios
En el ejemplo anterior se descargaron recetas ya definidas pero también se pueden compartir recetas entre usuarios, esto puede ser útil para compartir recetas que se han construido en base a la documentación de la encuesta o para compartir recetas que se han construido en base a la experiencia de los usuarios como se ve en el código 5.8.
5.3 Más sobre metasurvey
Para la construcción del paquete se ha realizado mucho trabajo en el desarrollo de cada una de las funciones, se ha buscado que el paquete sea lo más eficiente posible y que sea fácil de usar, se han realizado pruebas de rendimiento y se han buscado formas de optimizar el código para que sea lo más rápido posible.
En la Figura 5.3 se puede ver las dependencias de las funciones dentro de metasurvey, se puede ver que las funciones están muy bien organizadas y que se pueden utilizar de forma independiente, esto permite que el paquete sea muy flexible y que se puedan utilizar las funciones de forma independiente o en conjunto.
Desarrollar el paquete ha sido un proceso largo y complejo, pero ha sido muy gratificante ver cómo ha evolucionado puede ser utilizado por diferentes usuarios para diferentes tipos de encuestas, se espera que el paquete siga evolucionando y que se sigan incorporando nuevas funcionalidades y mejoras. Si bien el paquete ha sido desarrollado en base a las encuestas de hogares de Uruguay y Argentina, se espera que pueda ser utilizado para otras encuestas de hogares en América Latina y en otros países.
En futuras versiones se espera que el usuario pueda buscar y crear recetas de una interfaz gráfica, un registro de usuarios, monitoreo y analítica de uso, entre otras funcionalidades.
El paquete es muy flexible y la forma de que sea más útil es que los usuarios compartan sus recetas y que se puedan compartir entre usuarios, esto permitirá que el paquete sea más útil y que se puedan construir recetas más complejas y que se puedan compartir entre usuarios.
metasurvey y sus dependencias. Los nodos representan las funciones y las aristas las dependencias entre ellas.
5.4 Resumen
Los casos de uso presentados demuestran la flexibilidad y potencia de metasurvey para el procesamiento de diferentes encuestas de hogares:
En el caso de la ECH, se mostró cómo manejar eficientemente el nuevo diseño de panel rotativo y los pesos muestrales replicados bootstrap para generar estimaciones precisas de indicadores del mercado laboral.
Con la EPH, se evidenció la capacidad del paquete para adaptarse a diferentes estructuras de datos y metodologías de encuestas, manteniendo una interfaz consistente.
La visualización de recetas mediante
view_graph()facilita la comprensión de las dependencias entre variables y la transparencia en la construcción de indicadores.La posibilidad de compartir recetas entre usuarios permite aprovechar el conocimiento colectivo y acelerar el proceso de análisis de encuestas.
Estas características hacen de metasurvey una herramienta valiosa para investigadores y analistas que trabajan con encuestas de hogares en América Latina, proporcionando un marco unificado y eficiente para el procesamiento y análisis de datos.